MTTD (Mean Time To Detect): So messen und verkürzen Sie die mittlere Erkennungszeit
Vom Wissen zur Umsetzung – jetzt Timly kennenlernen!
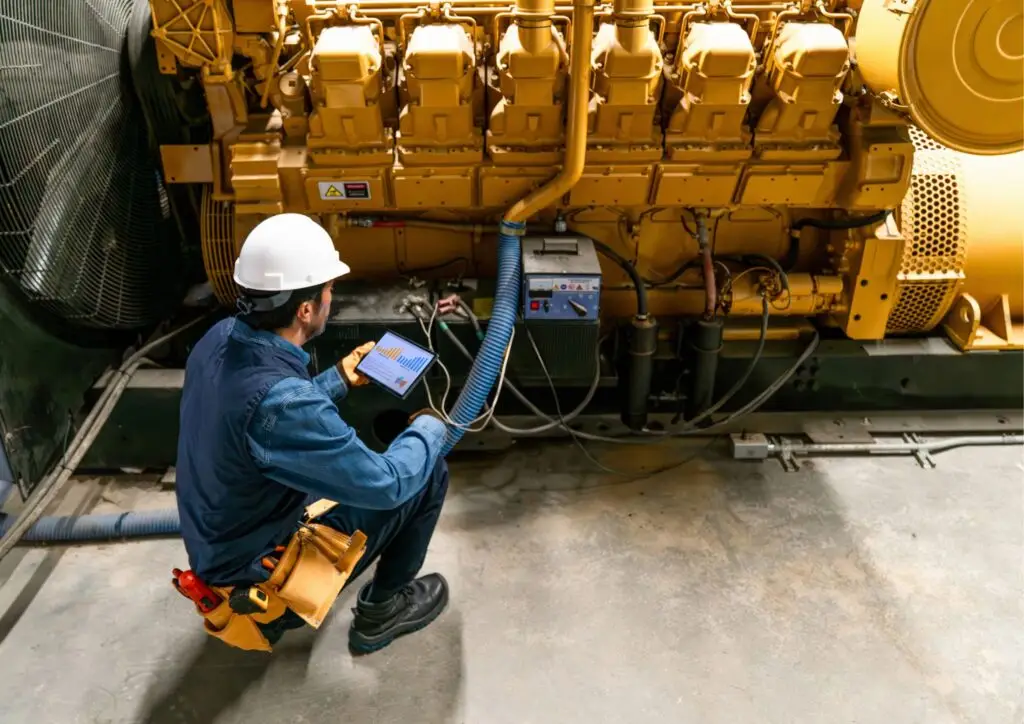
In vielen Unternehmen ist nicht nur die Störung selbst das Problem, sondern dass sie zu lange unbemerkt bleibt. Alarme gehen im E-Mail-Postfach unter, Protokolle werden nie ausgewertet, und Anlagen fallen aus, ohne dass jemand sie überwacht.
Genau diese Zeitspanne misst der MTTD (Mean Time To Detect): die mittlere Erkennungszeit zwischen dem Beginn eines Problems und dem Moment, in dem das zuständige Team davon erfährt. Ein niedriger MTTD zeigt, dass Überwachung und Alarmierung funktionieren. Ein hoher MTTD weist auf blinde Flecken hin, die Ausfallzeiten, Schäden und Sicherheitsrisiken erhöhen.
Was ist MTTD (Mean Time To Detect)?
Neben Mean Time To Detect ist auch der Begriff Mean Time To Discover verbreitet. Auf Deutsch spricht man von der mittleren Erkennungszeit oder der mittleren Entdeckungszeit. Gemeint ist in allen Fällen dasselbe: Wie schnell werden Fehler und Anomalien entdeckt?
Der MTTD betrachtet ausschließlich die Erkennungsphase eines Vorfalls, nicht die Reparatur oder Wiederherstellung. Damit beantwortet er eine einfache Frage: Wie lange bleiben Probleme im Durchschnitt unsichtbar?
Typische Merkmale der Kennzahl:
- Sie wird je nach Kontext in Minuten, Stunden oder Tagen angegeben.
- Sie bezieht sich auf einen festen Zeitraum, etwa einen Monat oder ein Quartal.
- Sie wird häufig nach Kritikalität getrennt ausgewertet, damit kritische Störungen nicht im Durchschnitt untergehen.
Einsatzbereiche: Instandhaltung, IT und Sicherheit
Bekannt geworden ist der MTTD vor allem in IT und Cybersecurity. Das Prinzip lässt sich aber genauso auf Instandhaltung, Betrieb und Asset Management übertragen.
| Bereich | Was als Beginn und Erkennung gilt |
|---|---|
| IT-Betrieb und SRE | Beginn eines Ausfalls oder einer Leistungsminderung bis zum ersten internen oder externen Alarm |
| Cybersecurity | Beginn eines Angriffs bis zur ersten Erkennung durch Sicherheitstools oder Analysten im Security Operations Center (SOC) |
| Instandhaltung und Asset Management | Ausfall oder Anomalie einer Maschine, Anlage oder Infrastruktur bis zur Erkennung durch Sensoren, Rundgänge oder Meldungen von Mitarbeitenden |
MTTD berechnen: Formel und Beispiel
Die Formel für die Mean Time To Detect ist in allen Branchen gleich:
MTTD = Summe aller Erkennungszeiten ÷ Anzahl der Vorfälle im Zeitraum
Die Erkennungszeit eines einzelnen Vorfalls ergibt sich aus: Zeitpunkt der Erkennung – Zeitpunkt des Störungsbeginns.
In 4 Schritten zur mittleren Erkennungszeit
- Umfang festlegen: Welche Vorfälle fließen ein (Maschinenausfälle, Serviceunterbrechungen, Sicherheitsalarme) und für welchen Zeitraum?
- Zeitpunkte erfassen: Beginn und Erkennung jedes Vorfalls werden mit Datum und Uhrzeit dokumentiert, etwa im Monitoring, in Logdateien, Tickets oder Instandhaltungsaufträgen.
- Erkennungszeit je Vorfall berechnen: Differenz zwischen Erkennung und Beginn.
- Durchschnitt bilden: Alle Erkennungszeiten addieren und durch die Anzahl der Vorfälle teilen.
Rechenbeispiel
In einem Quartal treten fünf Störungen auf. Sie werden nach 30, 30, 35, 45 und 120 Minuten erkannt.
- Summe der Erkennungszeiten: 30 + 30 + 35 + 45 + 120 = 260 Minuten
- Anzahl der Vorfälle: 5
- MTTD = 260 ÷ 5 = 52 Minuten
Das Beispiel zeigt auch eine Schwäche: Ein einzelner Ausreißer von 120 Minuten hebt den Durchschnitt deutlich an. Der Vergleich mit Vorperioden zeigt, ob sich die Erkennung verbessert oder verschlechtert.
MTTD, MTTR, MTBF und MTTF im Vergleich
Der MTTD ersetzt keine anderen Instandhaltungskennzahlen, sondern ergänzt sie um die Erkennungsphase. Erst zusammen ergeben sie ein vollständiges Bild vom Lebenszyklus einer Störung.
| Kennzahl | Deutsche Bezeichnung | Was sie misst | Phase |
|---|---|---|---|
| MTTD (Mean Time To Detect) | Mittlere Erkennungszeit | Zeit vom Beginn einer Störung bis zu ihrer Erkennung | Erkennung |
| MTTR (Mean Time To Repair/Restore) | Mittlere Reparaturzeit | Zeit bis zur Behebung bzw. Wiederherstellung | Reaktion und Behebung |
| MTTC (Mean Time To Contain) | Mittlere Eindämmungszeit | Zeit bis zur Eindämmung eines Sicherheitsvorfalls | Eindämmung |
| MTBF (Mean Time Between Failures) | Mittlere Betriebsdauer zwischen Ausfällen | Zeit zwischen zwei Ausfällen reparierbarer Anlagen | Zuverlässigkeit |
| MTTF (Mean Time To Failure) | Mittlere Zeit bis zum Ausfall | Lebensdauer nicht reparierbarer Komponenten | Lebensdauer |
In der Cybersecurity zeigen MTTD und MTTR zusammen, wie lange sich ein Angreifer unbemerkt im Netzwerk bewegen kann und wie schnell er gestoppt wird. Im IT-Betrieb bestimmen beide gemeinsam die für Nutzer spürbare Ausfallzeit und damit die Einhaltung von SLAs. In der Instandhaltung ergänzt der MTTD die Kennzahlen MTBF und MTTR um die Frage, ob Ausfälle rechtzeitig bemerkt werden.
Warum der MTTD so wichtig ist

Je kürzer die mittlere Erkennungszeit, desto kleiner das Zeitfenster, in dem eine Störung Schaden anrichten kann. In der Produktion verhindert eine schnell erkannte Anomalie Folgeschäden an Maschinen, Produktionsausfälle oder Gefahren für Mitarbeitende.
Vorteile eines niedrigen MTTD:
- Weniger Ausfallzeit: Störungen werden erkannt, bevor sie sich ausweiten oder Kunden sie bemerken.
- Geringerer Schaden bei Sicherheitsvorfällen: Angreifer haben weniger Zeit, sich im Netzwerk auszubreiten oder Daten abzuziehen.
- Mehr Vertrauen in die Überwachung: Teams können proaktiver arbeiten und Änderungen schneller umsetzen.
So verkürzen Sie die Mean Time To Detect
Ein niedrigerer MTTD entsteht aus technischen und organisatorischen Maßnahmen zugleich. Ziel ist, den Weg von „etwas läuft schief“ zu „die richtigen Personen wissen Bescheid“ zu verkürzen.
Überwachung ausbauen
In der IT bedeutet das umfassende Observability mit Logs, Metriken, Traces und Health Checks. In Produktion und Facility Management geht es um Sensoren, Steuerungen (SPS), SCADA-Systeme, IoT-Geräte, Zähler und Meldungen von Bedienpersonal. In beiden Fällen gilt: Relevante Abweichungen müssen sichtbare Signale erzeugen.
Alarmierung und Eskalation festlegen
Gute Überwachung nützt wenig, wenn Meldungen nicht rechtzeitig bei den richtigen Personen ankommen. Dafür braucht es:
- passende Schwellenwerte für jede Anlage und jeden Dienst,
- klare Zuständigkeiten je Team oder Bereitschaft,
- Eskalationsregeln, wenn kritische Alarme nicht in angemessener Zeit bearbeitet werden.
Daten auswerten und Anomalien erkennen
Algorithmen zur Anomalieerkennung finden, was feste Grenzwerte übersehen: eine langsam schleichende Leistungsminderung oder einen ungewöhnlichen Stromverbrauch. Regelmäßige Nachbesprechungen von Störungen zeigen zusätzlich, wo die Erkennung zu lange gedauert hat und welche Lücken geschlossen werden müssen.
Grenzen des MTTD und häufige Fehler
Wie jeder Durchschnittswert hat der MTTD Grenzen, die man vor wichtigen Entscheidungen kennen sollte.
- Durchschnitte verdecken Extremfälle: Sehr schnelle und sehr späte Erkennungen gleichen sich aus. Viele Teams berechnen den MTTD daher mit und ohne Ausreißer.
- Datenqualität entscheidet: Werden Beginn und Erkennung nicht einheitlich erfasst, ist der MTTD wenig aussagekräftig.
- Kritikalität fehlt: Ein niedriger MTTD bei kleinen Störungen kann über lange Erkennungszeiten bei kritischen Vorfällen hinwegtäuschen.
- Kein Ersatz für andere KPIs: Der MTTD sagt nichts über Ausfallhäufigkeit oder Reparaturdauer aus. Er sollte immer zusammen mit MTBF und MTTR betrachtet werden.
MTTD in Reports und Dashboards nutzen
Damit der MTTD zur Steuerungsgröße wird, gehört er fest in die Berichte von Instandhaltung, IT und Sicherheit.
- Zielwerte je Störungsart und Kritikalität festlegen statt eines einzigen Werts für alles.
- Den MTTD nach Teams, Standorten oder Anlagentypen aufschlüsseln, um blinde Flecken zu finden.
- Ihn mit Verfügbarkeit, Störungskosten und SLA-Erfüllung verknüpfen, damit Verbesserungen messbar werden.
Bei mehreren Standorten lohnt es sich, Störungen überall nach denselben Regeln zu erfassen. Nur so lassen sich Werte vergleichen und bewährte Verfahren übertragen.
Wie Timly die mittlere Erkennungszeit unterstützt
Viele Unternehmen erkennen Störungen zu spät, weil ihnen der Überblick über Anlagen, Wartungstermine und Einsatzorte fehlt. Arbeitet jede Abteilung mit eigenen Excel-Listen, lässt sich der MTTD weder zuverlässig berechnen noch gezielt verbessern. Eine digitale Instandhaltungssoftware wie Timly schafft eine gemeinsame Datenbasis.
So hilft Timly, die Mean Time To Detect zu senken:
- Zentrale Anlagendaten: Inventar, Wartungshistorie und Zustand jedes Assets liegen an einem Ort. Meldungen lassen sich so konkreten Geräten und Standorten zuordnen.
- Störungsmeldung per Ticket: Mitarbeitende melden Auffälligkeiten direkt per App und QR-Code. Zeitpunkt und betroffenes Asset werden automatisch erfasst, die Basis für eine saubere MTTD-Berechnung.
- Vorbeugende Instandhaltung: Geplante Wartungen und Prüfungen decken Anomalien auf, bevor sie zu Ausfällen werden.
- Gemeinsamer Informationsstand: Instandhaltung, IT und Betrieb arbeiten bei Störungen mit denselben aktuellen Daten.
Testen Sie Timly in der kostenlosen Testversion oder vereinbaren Sie eine unverbindliche Demo.
Fazit: MTTD als praxisnahe Kennzahl
Der MTTD zeigt, wie schnell ein Unternehmen merkt, dass etwas schiefläuft. Besonders wertvoll ist er dort, wo der Schaden weniger durch lange Reparaturen als durch späte Erkennung entsteht.
Zusammen mit MTTR, MTBF und MTTF ergibt die mittlere Erkennungszeit ein vollständiges Bild vom Lebenszyklus einer Störung. Mit verlässlicher Überwachung, klaren Meldewegen und sauberen Anlagendaten wird aus reaktiver Feuerwehrarbeit ein vorausschauender Betrieb.
FAQs: Häufig gestellte Fragen zu MTTD
Weitere Artikel

FMEA: Fehlermöglichkeits‑ und Einflussanalyse für Wartung und Qualitätsmanagement
4. August 2026
Inventur in der Gastronomie: Vorlagen und Tipps für Restaurants und Hotels
14. Juli 2026
Die Bedeutung von Lagerkennzahlen in Lagerlogistik, Einkauf & Controlling
4. Januar 2026
Körperliche Inventur: Ablauf, Vorteile und gesetzliche Anforderungen
2. Januar 2026
Change Management einfach erklärt: Veränderungsprozesse erfolgreich umsetzen
3. Juni 2026
Produktionseffizienz: Definition, Kennzahlen & Methoden zur Effizienzsteigerung
9. Dezember 2025